sentinelK
V2EX  ›  Local LLM

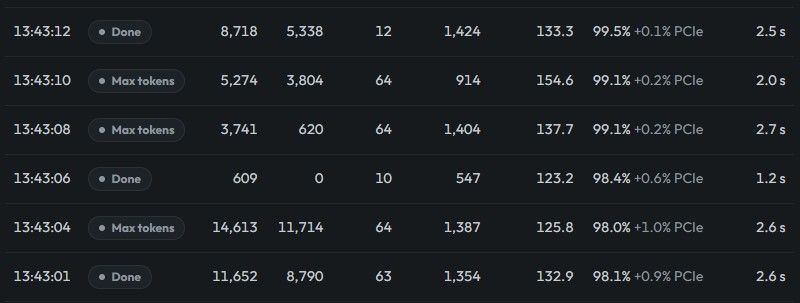
你好 NVFP4: strata-0.1.44.1, qwen3.8-flash-next, rtx pro 5000 48GB + 64GB RAM, decode 130t/s, prefill2600 t/s

  •  
  •   sentinelK · 2 days ago · 810 views

    如题。

    相较于只有ISTA-DASLab 孤立跑分的 IQ3 系列,nvfp4 有英伟达官方站台,所以其能力会更有说服力。 image.jpeg
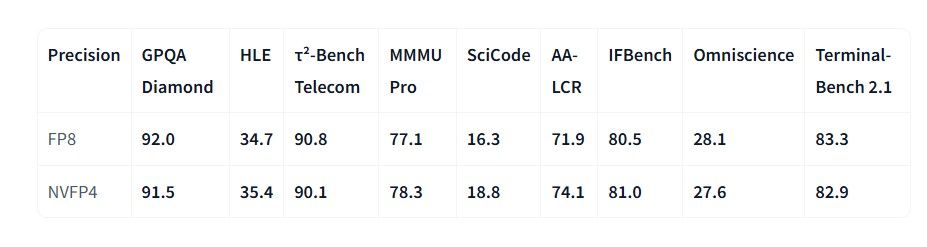
    更何况 nvfp4 并不是全 4bit ,很多参数都保持了全量 bf16 。

    对于 64GB ram + rtx pro 5000 48GB 而言。瓶颈主要是因为专家变大了,导致显存只能放进 13500 个专家,从而专家命中率从 99.7%降低至大概 97.x~99%。 image.jpeg image.jpeg
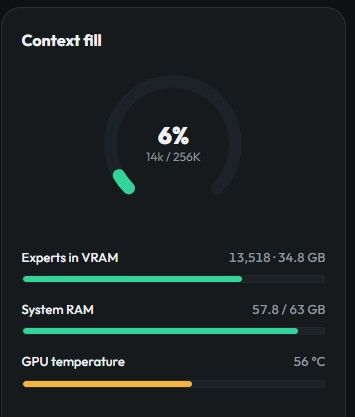
    然后就是因为内存的紧张,所以 Conversation cache 只能维系在 8GB ,4slot 。 image.jpeg
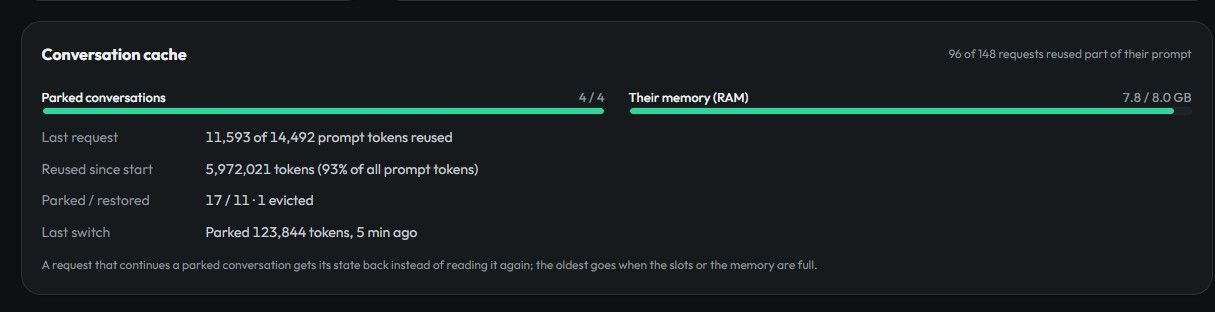
    其他的配置保持不变。 如惯例,贴出我的配置表:

    args": [
      "--pack",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\pack",
      "--native",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf",
      "--native-dense-gguf",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf",
      "--ple-gguf",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\ple-fp8.gguf",
      "--embd-gguf",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\token-embd-bf16.gguf",
      "--expert-profile",
      "C:\\work\\Strata\\data\\expert-profile.bin",
      "--expert-cache",
      "auto",
      "--prefill",
      "auto",
      "--spec",
      "4",
      "--mtp",
      "C:\\work\\Strata-data\\mtp\\rt",
      "--max-context",
      "262144",
      "--kv",
      "k8v4",
      "--resident-budget-gib",
      "39",
      "--vision",
      "--vram-reserve-mib",
      "700",
      "--spec-min-p",
      "0.5",
      "--pool-workers",
      "2",
      "--conversation-cache-mib",
      "8192",
      "--conversation-cache-min-tokens",
      "20000"
     ],
    
    7 replies  •  2026-10-15 14:17:41 +08:00
    catazshadow
        1
    catazshadow  
       2 days ago
    这个跟 IQ3 比会明显更聪明吗
    flkaylor19
        2
    flkaylor19  
       2 days ago
    @catazshadow 聪明 不循环
    sentinelK
        3
    sentinelK  
    OP
       2 days ago
    @catazshadow 如果从跑分角度讲,大概提升 5%,从困惑度角度讲降低 50%。

    实操中,比 IQ3_XXS 更少出现雷霆思考。代价就是对于 48 vram + 64ram 来讲,考虑到会话缓存,nvfp4 还是有点太极限了。
    catazshadow
        4
    catazshadow  
       1 day ago via Android
    @flkaylor19 我用 opencode ,iq3 倒是没见过循环
    catazshadow
        5
    catazshadow  
       1 day ago via Android
    @sentinelK 注意力漂移呢,会不会少点
    sentinelK
        6
    sentinelK  
    OP
       1 day ago
    @catazshadow 我是开的 262144 的上下文长度,一般来讲到 220k 的时候已经触发压缩了,所以没见过严重的注意力漂移
    catazshadow
        7
    catazshadow  
       1 day ago
    "--conversation-cache-mib",

    这个现在多卡也能用了
    About   ·   Help   ·   Advertise   ·   Blog   ·   API   ·   FAQ   ·   Privacy   ·   Solana   ·   2911 Online   Highest 6679   ·     Select Language
    创意工作者们的社区
    World is powered by solitude
    VERSION: 3.9.8.5 · 27ms · UTC 01:38 · PVG 09:38 · LAX 18:38 · JFK 21:38
    ♥ Do have faith in what you're doing.